
Treap 学习笔记
前置知识:朴素二叉搜索树,堆基础。
简介
Treap(树堆)是一种 弱平衡 的 二叉搜索树。
Treap 的结点除了被维护的 权值()之外,还附加了一个随机的 优先级(
其中,二叉搜索树的性质是指:
- 左子节点的权值()比父节点小。
- 右子节点的权值()比父节点大。
堆的性质是:
- 子节点优先级()比父节点大或小(取决于是小根堆还是大根堆
) 。
不难看出,如果用的是同一个值,那么这两种数据结构在组合后会变成一条链,所以我们再在搜索树的基础上,引入一个给堆的值 。对于 值,我们维护搜索树的性质,对于 值,我们维护堆的性质。其中 这个值是随机给出的。
下图就是一个 Treap 的例子(这里使用的是小根堆,即根节点的优先级最小
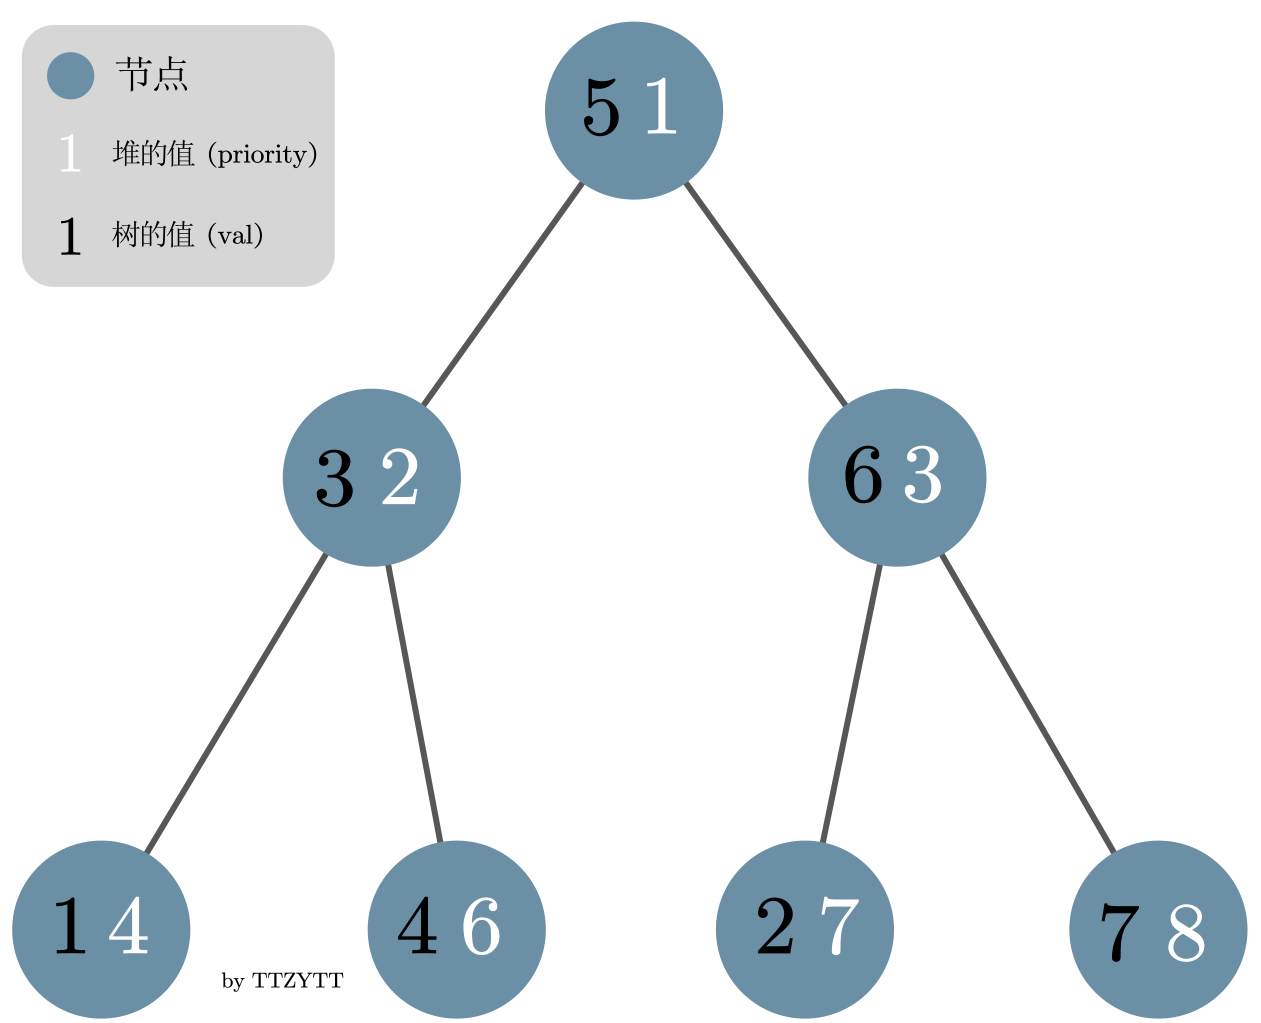
那我们为什么需要大费周章的去让这个数据结构符合树和堆的性质,并且随机给出堆的值呢?
要理解这个,首先需要理解朴素二叉搜索树的问题。在给朴素搜索树插入一个新节点时,我们需要从这个搜索树的根节点开始递归,如果新节点比当前节点小,那就向左递归,反之亦然。
最后当发现当前节点没有子节点时,就根据新节点的值的大小,让新节点成为当前节点的左或右子节点。
如果插入结点的权值是随机的(换言之,是随机插入的
不过,这只是在随机情况下的复杂度,如果我们按照下面这个非常有序的顺序给一个朴素的搜索树插入节点:
1 2 3 4 5那么这棵树将会退化成链,即变得非常「瘦长
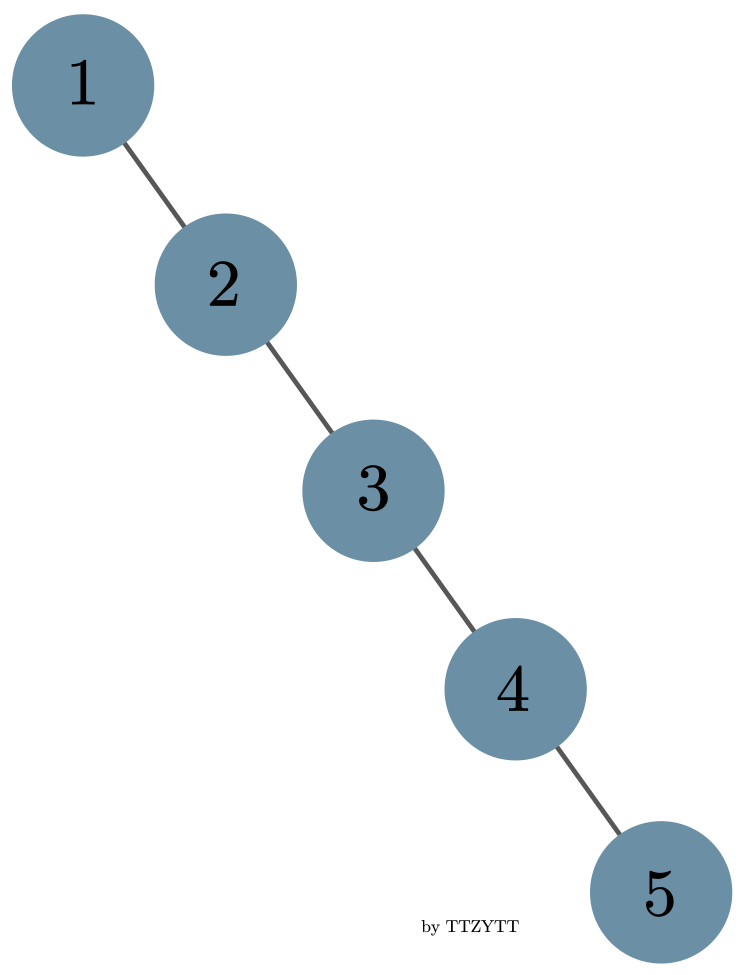
不难看出,查询的复杂度也从 变成了 .
而 treap 为了解决这个问题、达到一个较为「平衡」的状态,通过维护随机的优先级满足堆性质
Treap 复杂度的证明
由于 treap 各种操作的复杂度都和所操作的结点的深度有关,我们首先证明,所有结点的期望高度都是 .
记号约定
为了方便表述,我们约定:
- 是节点个数。
- Treap 结点中满足二叉搜索树性质的称为 权值,满足堆性质的(也就是随机的)称为 优先级。不妨设优先级满足小根堆性质。
- 表示权值第 小的结点。
- 表示集合 ,即按权值升序排列后第 个到第 个的结点构成的集合。
- 表示结点 的深度。规定根节点的深度是 .
- 是一个指示器随机变量,当 是 的祖先时值为 ,否则为 . 特别地,.
- 表示事件 发生的概率。
树高的证明
由于结点 的深度等于它祖先的个数,因此有
那么根据期望的线性性,有
由于 是指示器随机变量,它的期望就等于它为 的概率,因此
我们先证明引理: 当且仅当 的优先级是 中最小的。
引理的证明
证明:考虑分类讨论 和 的情况。
- 若 是根节点:由于优先级满足小根堆性质, 的优先级最小,并且对于任意的 , 都是 的祖先。
- 若 是根节点:同理, 优先级最小,因此 不是 中优先级最小的;同时 也不是 的祖先。
- 若 和 在根节点的两个子树中(一左一右
) , ) 。 - 若 和 在根节点的同一个子树中,此时可以将这个子树单独拿出来作为一棵新的 treap,递归进行上面的证明即可。
那么根据引理,深度的期望可以转化成
又因为结点的优先级是随机的,我们假定集合 中任何一个结点的优先级最小的概率都相同,那么
因此每个结点的期望高度都是 .
而朴素的二叉搜索树的操作的复杂度均是 ,同时 treap 维护堆性质的复杂度也是 的,因此 treap 各种操作的期望复杂度都是 .
期望复杂度的感性理解
首先,我们需要认识到一个节点的 属性是和它所在的层数有直接关联的。再回忆堆的性质:
- 子节点值()比父节点大或小(取决于是小根堆还是大根堆)
我们发现层数低的节点,比如整个树的根节点,它的 属性也会更小(在小根堆中
给 treap 插入新节点时,需要同时维护树和堆的性质。其中,搜索树的性质可以在插入时维护,而堆性质的维护则有两种处理方法,分别是旋转和分裂、合并。使用这两种方法的 treap 被分别称为 旋转 treap 和 无旋 treap。
旋转 treap
旋转 treap 维护平衡的方式为旋转,和 AVL 树的旋转操作类似,分为 左旋 和 右旋。即在满足二叉搜索树的条件下根据堆的优先级对 treap 进行平衡操作。
旋转 treap 在做普通平衡树题的时候,是所有平衡树中常数较小的。
节点结构
struct Node {
    Node *ch[2]; // 两个子节点的地址
    int val, rank;
    int rep_cnt; // 当前这个值(val)重复出现的次数
    int siz;     // 以当前节点为根的子树大小

    Node(int val) : val(val), rep_cnt(1), siz(1) {
        ch[0] = ch[1] = nullptr;
        rank = rand();
        // 注意初始化的时候,rank 是随机给出的
    }

    void upd_siz() {
        // 用于旋转和删除过后,重新计算 siz 的值
        siz = rep_cnt;
        if (ch[0] != nullptr)
            siz += ch[0]->siz;
        if (ch[1] != nullptr)
            siz += ch[1]->siz;
    }
};
旋转
旋转操作是 treap 的一个非常重要的操作,主要用来在保持 treap 树性质的同时,调整不同节点的层数,以达到维护堆性质的作用。
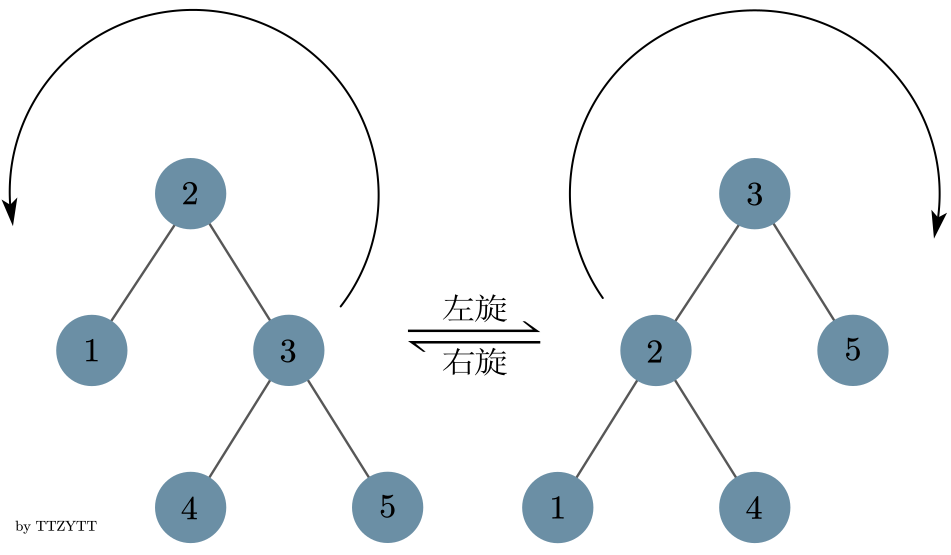
旋转操作的左旋和右旋可能不是特别容易区分,以下是两个较为明显的特点:
旋转操作的含义:
- 在不影响搜索树性质的前提下,把和旋转方向相反的子树变成根节点(如左旋,就是把右子树变成根节点)
- 不影响性质,并且在旋转过后,跟旋转方向相同的子节点变成了原来的根节点(如左旋,旋转完之后的左子节点是旋转前的根节点)
左旋和右旋操作是相互的,如下图。
enum rot_type { LF = 1, RT = 0 };

void _rotate(Node *&cur,
             rot_type dir) { // dir参数代表旋转的方向 0为右旋,1为左旋
    // 注意传进来的 cur 是指针的引用,也就是改了这个
    // cur,变量是跟着一起改的,如果这个 cur 是别的 树的子节点,根据 ch
    // 找过来的时候,也是会找到这里的

    // 以下的代码解释的均是左旋时的情况
    Node *tmp =
        cur->ch[dir]; // 让 C 变成根节点,
                      // 这里的 tmp
                      // 是一个临时的节点指针,指向成为新的根节点的节点

    /* 左旋:也就是让右子节点变成根节点
     *         A                 C
     *        / \               / \
     *       B  C    ---->     A   E
     *         / \            / \
     *        D   E          B   D
     */
    cur->ch[dir] = tmp->ch[!dir];   // 让 A 的右子节点变成 D
    tmp->ch[!dir] = cur;            // 让 C 的左子节点变成 A
    cur->upd_siz(), tmp->upd_siz(); // 更新大小信息
    cur = tmp; // 最后把临时储存 C 树的变量赋值到当前根节点上(注意 cur
               // 是引用)
}
插入
类似普通二叉搜索树的插入,但是需要在插入的过程中通过旋转来维护优先级的堆性质。
void _insert(Node *&cur, int val) {
    if (cur == nullptr) {
        // 没这个节点直接新建
        cur = new Node(val);
        return;
    } else if (val == cur->val) {
        // 如果有这个值相同的节点,就把重复数量加一
        cur->rep_cnt++;
        cur->siz++;
    } else if (val < cur->val) {
        // 维护搜索树性质,val 比当前节点小就插到左边,反之亦然
        _insert(cur->ch[0], val);
        if (cur->ch[0]->rank < cur->rank) {
            // 小根堆中,上面节点的优先级一定更小
            // 因为新插的左子节点比父节点小,现在需要让左子节点变成父节点
            _rotate(
                cur,
                RT); // 注意前面的旋转性质,要把左子节点转上来,需要右旋
        }
        cur->upd_siz(); // 插入之后大小会变化,需要更新
    } else {
        _insert(cur->ch[1], val);
        if (cur->ch[1]->rank < cur->rank) {
            _rotate(cur, LF);
        }
        cur->upd_siz();
    }
}
删除
主要就是分类讨论,不同的情况有不同的处理方法,删完了树的大小会有变化,要注意更新。并且如果要删的节点有左子树和右子树,就要考虑删除之后让谁来当父节点(维护 rank 小的节点在上面
void _del(Node *&cur, int val) {
    if (val > cur->val) {
        _del(cur->ch[1], val);
        // 值更大就在右子树,反之亦然
        cur->upd_siz();
    } else if (val < cur->val) {
        _del(cur->ch[0], val);
        cur->upd_siz();
    } else {
        if (cur->rep_cnt > 1) {
            // 如果要删除的节点是重复的,可以直接把重复值减小
            cur->rep_cnt--, cur->siz--;
            return;
        }
        uint8_t state = 0;
        state |= (cur->ch[0] != nullptr);
        state |= ((cur->ch[1] != nullptr) << 1);
        // 00都无,01有左无右,10,无左有右,11都有
        Node *tmp = cur;
        switch (state) {
        case 0:
            delete cur;
            cur = nullptr;
            // 没有任何子节点,就直接把这个节点删了
            break;
        case 1: // 有左无右
            cur = tmp->ch[0];
            // 把根变成左儿子,然后把原来的根节删了,注意这里的 tmp 是从
            // cur 复制的,而 cur 是引用
            delete tmp;
            break;
        case 2: // 有右无左
            cur = tmp->ch[1];
            delete tmp;
            break;
        case 3:
            rot_type dir = cur->ch[0]->rank < cur->ch[1]->rank
                               ? RT
                               : LF; // dir 是 rank 更小的那个儿子
            _rotate(cur,
                    dir); // 这里的旋转可以把优先级更小的儿子转上去,rt 是
                          // 0, 而 lf 是 1,刚好跟实际的子树下标反过来
            _del(
                cur->ch[!dir],
                val); // 旋转完成后原来的根节点就在旋方向那边,所以需要
                      // 继续把这个原来的根节点删掉
                      // 如果说要删的这个节点是在整个树的「上层的」,那我们会一直通过这
                      // 这里的旋转操作,把它转到没有子树了(或者只有一个),再删掉它。
            cur->upd_siz();
            // 删除会造成大小改变
            break;
        }
    }
}
根据值查询排名
操作含义:查询以 cur 为根节点的子树中,val 这个值的大小的排名(该子树中小于 val 的节点的个数 + 1)
int _query_rank(Node *cur, int val) {
    int less_siz = cur->ch[0] == nullptr ? 0 : cur->ch[0]->siz;
    // 这个树中小于 val 的节点的数量
    if (val == cur->val)
        // 如果这个节点就是要查的节点
        return less_siz + 1;
    else if (val < cur->val) {
        if (cur->ch[0] != nullptr)
            return _query_rank(cur->ch[0], val);
        else
            return 1; // 如果左子树是空的,说比最小的节点还要小,那这个数字就是最小的
    } else {
        if (cur->ch[1] != nullptr)
            // 如果要查的值比这个节点大,那这个节点的左子树以及这个节点自身肯定都比要查的值小
            // 所以要加上这两个值,再加上往右边找的结果
            // (以右子树为根的子树中,val 这个值的大小的排名)
            return less_siz + cur->rep_cnt + _query_rank(cur->ch[1], val);
        else
            return cur->siz + 1;
        // 没有右子树的话直接整个树 + 1 相当于 less_siz + cur->rep_cnt + 1
    }
}
根据排名查询值
要根据排名查询值,我们首先要知道如何判断要查的节点在树的哪个部分:
以下是一个判断方法的表:
| 左子树 | 根节点/当前节点 | 右子树 |
|---|---|---|
| 排名 ≤ 左子树的大小 | 排名 > 左子树的大小,并且 ≤ 左子树的大小 + 根节点的重复次数 | 排名 > 左子树的大小 + 根节点的重复次数 |
注意如果在右子树,递归的时候需要对原来的 rank 进行处理。递归的时候就相当去查,在右子树中为这个排名的值,为了把排名转换成基于右子树的,需要把原来的 rank 减去左子树的大小和根节点的重复次数。
可以把所有节点想象成一个排好序的数组,或者数轴(如下
1 -> |左子树的节点|根节点|右子树的节点| -> n
                           ^
                           要查的排名
                     ⬇转换成基于右子树的排名
1 -> |右子树的节点| -> n
       ^
       要查的排名
这里的转换方法就是直接把排名减去左子树的大小和根节点的重复数量。
int _query_val(Node *cur, int rank) {
    // 查询树中第 rank 大的节点的值
    int less_siz = cur->ch[0] == nullptr ? 0 : cur->ch[0]->siz;
    // less siz 是左子树的大小
    if (rank <= less_siz)
        return _query_val(cur->ch[0], rank);
    else if (rank <= less_siz + cur->rep_cnt)
        return cur->val;
    else
        return _query_val(cur->ch[1],
                          rank - less_siz - cur->rep_cnt); // 见前文
}
查询第一个比 val 小的节点
注意这里使用了一个类中的全局变量,q_prev_tmp。
这个值是只有在 val 比当前节点值大的时候才会被更改的,所以返回这个变量就是返回 val 最后一次比当前节点的值大,之后就是更小了。
int _query_prev(Node *cur, int val) {
    if (val <= cur->val) {
        // 还是比 val 大,所以往左子树找
        if (cur->ch[0] != nullptr)
            return _query_prev(cur->ch[0], val);
    } else {
        // 只有能进到这个 else 里,才会更新 q_prev_tmp 的值
        q_prev_tmp = cur->val;
        // 当前节点已经比
        // val,小了,但是不确定是否是最大的,所以要到右子树继续找
        if (cur->ch[1] != nullptr)
            _query_prev(cur->ch[1], val);
        // 接下来的递归可能不会更改 q_prev_tmp
        // 了,那就直接返回这个值,总之返回的就是最后一次进到 这个 else
        // 中的 cur->val
        return q_prev_tmp;
    }
    return NIL;
}
查询第一个比 val 大的节点
跟前一个很相似,只是大于小于号换了一下。
int _query_nex(Node *cur, int val) {
    if (val >= cur->val) {
        if (cur->ch[1] != nullptr)
            return _query_nex(cur->ch[1], val);
    } else {
        q_nex_tmp = cur->val;
        if (cur->ch[0] != nullptr)
            _query_nex(cur->ch[0], val);
        return q_nex_tmp;
    }
    return NIL;
}
无旋 treap
无旋 treap 的操作方式使得它天生支持维护序列、可持久化等特性。
无旋 treap 又称分裂合并 treap。它仅有两种核心操作,即为 分裂 与 合并。通过这两种操作,在很多情况下可以比旋转 treap 更方便的实现别的操作。下面逐一介绍这两种操作。
分裂(split)
按值分裂
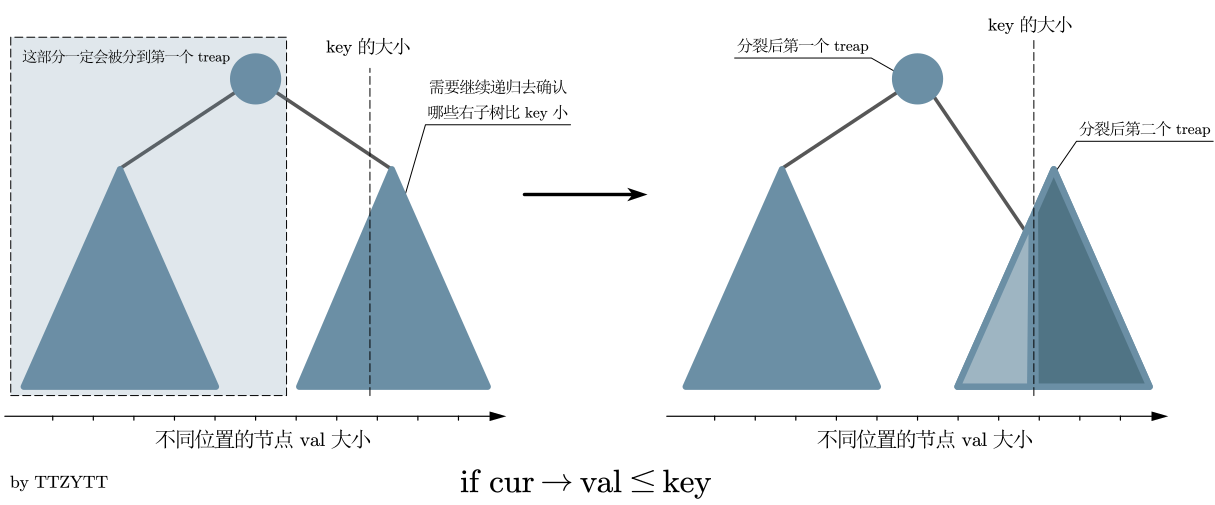
分裂过程接受两个参数:根指针 、关键值 。结果为将根指针指向的 treap 分裂为两个 treap,第一个 treap 所有结点的值()小于等于 ,第二个 treap 所有结点的值大于 。
该过程首先判断 是否小于 的值,若小于,则说明 及其右子树全部大于 ,属于第二个 treap。当然,也可能有一部分的左子树的值大于 ,所以还需要继续向左子树递归地分裂。对于大于 的那部分左子树,我们把它作为 的左子树,这样,整个 上的节点都是大于 的。
相应的,如果 大于等于 的值,说明 的整个左子树以及其自身都小于 ,属于分裂后的第一个 treap。并且, 的部分右子树也可能有部分小于 ,因此我们需要继续递归地分裂右子树。把小于 的那部分作为 的右子树,这样,整个 上的节点都小于 。
下图展示了 的值小于等于 时按值分裂的情况。
pair<Node *, Node *> split(Node *cur, int key) {
    if (cur == nullptr)
        return {nullptr, nullptr};
    if (cur->val <= key) {
        // cur 以及它的左子树一定属于分裂后的第一个树
        auto temp = split(cur->ch[1], key);
        // 但是它可能有部分右子树也比 key 小
        cur->ch[1] = temp.first;
        // 我们把小于 key 的那部分拿出来,作为 cur 的右子树,这样整个 cur
        // 都是小于 key 的 剩下的那部分右子树成为分裂后的第二个 treap
        cur->upd_siz();
        // 分裂过后树的大小会变化,需要更新
        return {cur, temp.second};
    } else {
        // 同上
        auto temp = split(cur->ch[0], key);
        cur->ch[0] = temp.second;
        cur->upd_siz();
        return {temp.first, cur};
    }
}
按排名分裂
比起按值分裂,这个操作更像是旋转 treap 中的根据排名(某个节点的排名是树中所有小于此节点值的节点的数量 )查询值:
此函数接受两个参数,节点指针 和排名 ,返回分裂后的三个 treap。
其中,第一个 treap 中每个节点的排名都小于 ,第二个的排名等于 ,并且第二个 treap 只有一个节点(不可能有多个等于的,如果有的话会增加 Node 结构体中的 cnt
此操作的重点在于判断排名和 相等的节点在树的哪个部分,这也是旋转 treap 根据排名查询值操作时的重要部分,在前文有非常详细的解释,这里不过多讲解。
并且,此操作的递归部分和按值分裂也非常相似,这里不赘述。
tuple<Node *, Node *, Node *> split_by_rk(Node *cur, int rk) {
    if (cur == nullptr)
        return {nullptr, nullptr, nullptr};
    int ls_siz = cur->ch[0] == nullptr ? 0 : cur->ch[0]->siz;
    if (rk <= ls_siz) {
        // 排名和 cur 相等的节点在左子树
        Node *l, *mid, *r;
        tie(l, mid, r) = split_by_rk(cur->ch[0], rk);
        cur->ch[0] = r; // 返回的第三个 treap 中的排名都大于 rk
        // cur 的左子树被设成 r 后,整个 cur 中节点的排名都大于 rk
        cur->upd_siz();
        return {l, mid, cur};
    } else if (rk <= ls_siz + cur->cnt) {
        // 和 cur 相等的就是当前节点
        Node *lt = cur->ch[0];
        Node *rt = cur->ch[1];
        cur->ch[0] = cur->ch[1] = nullptr;
        // 分裂后第二个 treap 只有一个节点,所有要把它的子树设置为空
        return {lt, cur, rt};
    } else {
        // 排名和 cur 相等的节点在右子树
        // 递归过程同上
        Node *l, *mid, *r;
        tie(l, mid, r) = split_by_rk(cur->ch[1], rk - ls_siz - cur->cnt);
        cur->ch[1] = l;
        cur->upd_siz();
        return {cur, mid, r};
    }
}
合并(merge)
合并过程接受两个参数:左 treap 的根指针 、右 treap 的根指针 。必须满足 中所有结点的值小于等于 中所有结点的值。一般来说,我们合并的两个 treap 都是原来从一个 treap 中分裂出去的,所以不难满足 中所有节点的值都小于
在旋转 treap 中,我们借助旋转操作来维护 符合堆的性质,同时旋转时还不能改变树的性质。在无旋 treap 中,我们用合并达到相同的效果。
因为两个 treap 已经有序,所以我们在合并的时候只需要考虑把哪个树「放在上面
同时,我们还需要满足搜索树的性质,所以若 的根结点的 小于 的,那么 即为新根结点,并且 因为值比 更大,应与 的右子树合并;反之,则 作为新根结点,然后因为 的值比 小,与 的左子树合并。
Node *merge(Node *u, Node *v) {
    // 传进来的两个树的内部已经符合搜索树的性质了
    // 并且 u 内所有节点的值 < v 内所有节点的值
    // 所以在合并的时候需要维护堆的性质
    // 这里用的是小根堆
    if (u == nullptr && v == nullptr)
        return nullptr;
    if (u != nullptr && v == nullptr)
        return u;
    if (v != nullptr && u == nullptr)
        return v;

    if (u->prio < v->prio) {
        // u 的 prio 比较小,u应该作为父节点
        u->ch[1] = merge(u->ch[1], v);
        // 因为 v 比 u 大,所以把 v 作为 u 的右子树
        u->upd_siz();
        return u;
    } else {
        // v 比较小,v应该作为父节点
        v->ch[0] = merge(u, v->ch[0]);
        // u 比 v 小,所以递归时的参数是这样的
        v->upd_siz();
        return v;
    }
}
插入
在无旋 treap 中,插入,删除,根据值查询排名等基础操作既可以用普通二叉查找树的方法实现,也可以用分裂和合并来实现。通常来说,使用分裂和合并来实现更加简洁,但是速度会慢一点。为了帮助更好的理解无旋 treap,下面的操作全部使用分裂和合并实现。
在实现插入操作时,我们利用了分裂操作的一些性质。也就是值小于等于 的节点会被分到第一个 treap。
所以,假设我们根据 分裂当前这个 treap。会有下面两棵树,并符合以下条件:
其中 表示分裂后所有被分到第一个 treap 的节点的集合, 则是第二个。
如果我们再按照 继续分裂 ,那么会产生下面两棵树,并符合以下条件:
其中 表示 分裂后所有被分到第一个 treap 的节点的集合, 则是第二个。并且上面的式子中,后半部分的 来自于 所符合的条件 。
不难发现,只要 和节点的值是一个整数(大多数使用场景下会使用整数)那么符合 条件的节点只有一个,也就是值等于 的节点。
在插入时,如果我们发现符合 的节点存在,那就可以直接增加重复次数,否则,就新开一个节点。
注意把树分裂好了还需要用合并操作把它「粘」回去,这样下次还能继续使用。并且,还需要注意合并操作的参数顺序是有要求的,第一个树的所有节点的值都需要小于第二个。
void insert(int val) {
    auto temp = split(root, val);
    // 根据 val 的值把整个树分成两个
    // 注意 split 的实现,等于 val 的子树是在左子树的
    auto l_tr = split(temp.first, val - 1);
    // l_tr 的左子树 <= val - 1,如果有 = val 的节点,那一定在右子树
    Node *new_node;
    if (l_tr.second == nullptr) {
        // 没有这个节点就新开,否则直接增加重复次数。
        new_node = new Node(val);
    } else {
        l_tr.second->cnt++;
        l_tr.second->upd_siz();
    }
    Node *l_tr_combined =
        merge(l_tr.first, l_tr.second == nullptr ? new_node : l_tr.second);
    // 合并 T_1 left 和 T_1 right
    root = merge(l_tr_combined, temp.second);
    // 合并 T_1 和 T_2
}
删除
删除操作也使用和插入操作相似的方法,找到值和 相等的节点,并且删除它。
void del(int val) {
    auto temp = split(root, val);
    auto l_tr = split(temp.first, val - 1);
    if (l_tr.second->cnt > 1) {
        // 如果这个节点的重复次数大于 1,减小即可
        l_tr.second->cnt--;
        l_tr.second->upd_siz();
        l_tr.first = merge(l_tr.first, l_tr.second);
    } else {
        if (temp.first == l_tr.second) {
            // 有可能整个 T_1 只有这个节点,所以也需要把这个点设成 null
            // 来标注已经删除
            temp.first = nullptr;
        }
        delete l_tr.second;
        l_tr.second = nullptr;
    }
    root = merge(l_tr.first, temp.second);
}
根据值查询排名
排名是比这个值小的节点的数量 ,所以我们根据 分裂当前树,那么分裂后的第一个树就符合:
如果树的值和 为整数,那么 就包含了所有值小于 的节点。
int qrank_by_val(Node *cur, int val) {
    auto temp = split(cur, val - 1);
    int ret =
        (temp.first == nullptr ? 0 : temp.first->siz) + 1; // 根据定义 + 1
    root = merge(temp.first, temp.second); // 拆好了再粘回去
    return ret;
}
根据排名查询值
调用 split_by_rk() 函数后,会返回分裂好的三个 treap,其中第二个只包含一个节点,它的排名等于 ,所以我们直接返回这个节点的 。
int qval_by_rank(Node *cur, int rk) {
    Node *l, *mid, *r;
    tie(l, mid, r) = split_by_rk(cur, rk);
    int ret = mid->val;
    root = merge(merge(l, mid), r);
    return ret;
}
查询第一个比 val 小的节点
可以把这个问题转化为,在比 小的所有节点中,找出排名最大的。我们根据 来分裂这个 treap,返回的第一个 treap 中的节点的值就全部小于 ,然后我们调用 qval_by_rank() 找出这个树中值最大的节点。
int qprev(int val) {
    auto temp = split(root, val - 1);
    // temp.first 就是值小于 val 的子树
    int ret = qval_by_rank(temp.first, temp.first->siz);
    // 这里查询的是,所有小于 val 的节点里面,最大的那个的值
    root = merge(temp.first, temp.second);
    return ret;
}
查询第一个比 val 大的节点
和上个操作类似,可以把这个问题转化为,在比 大的所有节点中,找出排名最小的。那么根据 分裂后,返回的第二个 treap 中的所有节点的值就大于 。
然后我们去查询这个树中排名为 的节点(也就是值最小的节点)的值,就可以成功查到第一个比 大的节点。
int qnex(int val) {
    auto temp = split(root, val);
    int ret = qval_by_rank(temp.second, 1);
    // 查询所有大于 val 的子树里面,值最小的那个
    root = merge(temp.first, temp.second);
    return ret;
}
建树(build)
将一个有 个节点的序列 转化为一棵 treap。
可以依次暴力插入这 个节点,每次插入一个权值为 的节点时,将整棵 treap 按照权值分裂成权值小于等于 的和权值大于 的两部分,然后新建一个权值为 的节点,将两部分和新节点按从小到大的顺序依次合并,单次插入时间复杂度 ,总时间复杂度 。
在某些题目内,可能会有多次插入一段有序序列的操作,这是就需要在 的时间复杂度内完成建树操作。
方法一:在递归建树的过程中,每次选取当前区间的中点作为该区间的树根,并对每个节点钦定合适的优先值,使得新树满足堆的性质。这样能保证树高为 。
方法二:在递归建树的过程中,每次选取当前区间的中点作为该区间的树根,然后给每个节点一个随机优先级。这样能保证树高为 ,但不保证其满足堆的性质。这样也是正确的,因为无旋式 treap 的优先级是用来使 merge 操作更加随机一点,而不是用来保证树高的。
方法三:观察到 treap 是笛卡尔树,利用笛卡尔树的 建树方法即可,用单调栈维护右链即可。